


Article rédigé par Michel Mouchon, le 14 octobre 2026
Sur IBM i, la vraie limite n’a jamais été la puissance de calcul. C’est la capacité à faire passer du changement en toute sécurité, sur une plateforme partagée où une modification mal maîtrisée peut coûter cher. Voici comment faire entrer des agents IA dans le pipeline DevOps sans renoncer aux garde-fous qui protègent la production.
La contrainte n’est pas la capacité de calcul. C’est la capacité de changement.
Le vrai goulot d’étranglement
Quand on parle d’IA appliquée à DevOps, l’image qui vient spontanément est celle d’un développeur qui code plus vite. Ce n’est pas l’histoire qui compte vraiment sur IBM i.
La vraie histoire commence quand on passe du développeur à l’équipe, puis à la plateforme d’entreprise, c’est là que la livraison tient ou casse. Sur un parc IBM i qui fait tourner des centaines d’applications interconnectées, à travers plusieurs pays et/ou plusieurs équipes, la contrainte n’a jamais été la capacité de calcul. C’est la capacité de changement : combien de modifications peut-on faire passer en production sans casser ?
Beaucoup d’organisations ont déjà franchi une première étape avec des assistants de code. C’est un bon point de départ : ils réduisent le temps du premier jet, expliquent du code existant, accélèrent la documentation. Mais s’ils optimisent la productivité individuelle d’un développeur, ce qui ralentit vraiment une livraison en production reste inchangé : l’analyse d’impact, les tests, la constitution de preuves pour l’audit. C’est-à-dire tout ce qui, dans un environnement réglementé ou à haute disponibilité, se joue après le premier jet de code.
Ce que « perdre le contrôle » veut dire, concrètement
IBM i n’est pas un terrain de jeu pour l’automatisation en boîte noire. C’est un environnement partagé, à très forte charge de contexte, où les programmes RPG, COBOL, CL et les composants DB2 sont reliés par des dépendances que seule une poignée d’experts maîtrise encore complètement. Et cette poignée se réduit d’une génération à l’autre.
Dans ce contexte, « perdre le contrôle » a un sens très concret : un agent qui modifie du code sans justification traçable ; un changement qui atterrit en environnement de test sans que personne ne puisse dire pourquoi ; des accès trop larges accordés par facilité ; une séparation des tâches qui disparaît parce que le même agent propose et exécute.
Rien de tout cela n’est une fatalité liée à l’IA elle-même. C’est une conséquence directe de la façon dont on la fait entrer dans le pipeline.
Un agent qui instruit, pas qui décide
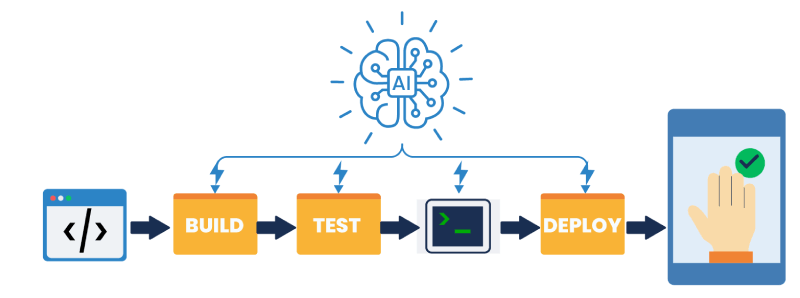
La bonne nouvelle, c’est que ce problème n’est pas nouveau : c’est celui de toute automatisation à privilèges élevés. La réponse n’est pas de retirer les contrôles pour aller plus vite, mais de les rendre répétables, visibles, et rapides à exécuter. Concrètement, sur une demande de changement IBM i, ça donne ce déroulé :
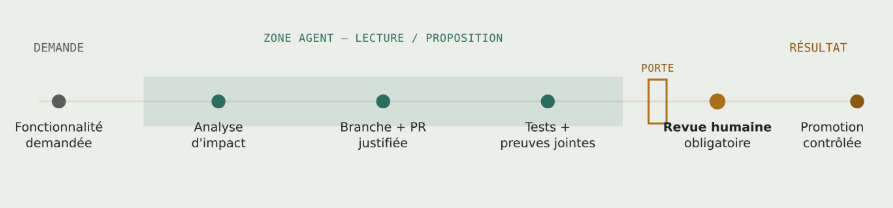
L’agent instruit le dossier (analyse, proposition, preuves) mais ne franchit jamais la porte seul. La revue humaine reste le passage obligé avant toute promotion vers un environnement supérieur.
Le point clé n’est pas de retirer les contrôles, mais de les rendre systématiques : chaque étape produite par l’agent est journalisée, chaque « pull request » porte sa justification et ses risques, et la promotion reste une décision humaine, appuyée sur des preuves déjà réunies plutôt que reconstituées dans l’urgence.
Une trajectoire de maturité, pas un saut dans le vide
Parce que l’environnement IBM i est partagé, l’adoption ne peut pas être un pari. Elle avance par paliers, chacun validé avant de passer au suivant.
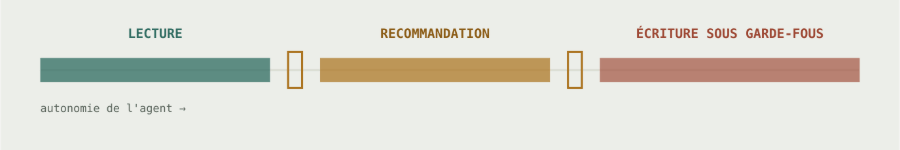
Lecture
Cartographie des dépendances, documentation, recommandations de tests. Risque quasi nul, valeur immédiate, c’est le terrain d’entraînement de la confiance.
Recommandation
L’agent rédige une pull request mais ne la fusionne jamais. La décision de merger reste humaine, à chaque fois.
Écriture sous garde-fous
Une fois la confiance établie, l’agent peut écrire en développement ou en test, toujours derrière des « pull requests » et des approbations obligatoires.
L’élargissement du périmètre s’accompagne systématiquement de portes de sortie plus strictes, jamais l’inverse. Cette progression permet d’obtenir de la valeur tôt, sans faire de pari sur la discipline opérationnelle qui protège la production.
Cinq garde-fous non négociables
Une fois la trajectoire posée, la gouvernance elle-même doit être conçue comme celle de n’importe quelle automatisation à privilèges élevés, pas comme une case à cocher ajoutée après coup.
- Identités et moindre privilège. Chaque agent, qu’il agisse pour le compte d’un humain ou de façon autonome, dispose de sa propre identité et des seuls droits nécessaires à sa tâche.
- Humain in the loop. Les approbations et les revues restent obligatoires, et cette obligation s’impose techniquement dans le pipeline : protections de branche, portes de contrôle qu’on ne peut pas contourner.
- Whitelist des serveurs et outils MCP. Le Model Context Protocol relie les agents aux outils : il se gouverne comme n’importe quelle interface, en définissant précisément ce à quoi un agent peut accéder, rien de plus.
- Journalisation systématique. Chaque invocation d’outil ou d’agent est enregistrée, pour l’audit comme pour la réponse à incident.
- Un modèle de gouvernance IA formalisé. Au-delà des contrôles techniques, l’organisation doit avoir statué sur qui décide, qui valide, et jusqu’où va le périmètre autorisé.
Dans un SDLC agentique, la gouvernance n’est pas une taxe sur la vitesse. C’est ce qui la rend possible.
Comment ARCAD construit ce contrôle dans son architecture
C’est le principe qui structure la plateforme agentique d’ARCAD : l’agent raisonne et propose, mais c’est un moteur de workflow, déterministe et journalisé qui exécute. Pas d’improvisation du modèle sur une action sensible.
L’architecture repose sur trois piliers. La connaissance (RAG) ancre les réponses de l’agent dans plus de trente ans de méthodologie ARCAD plutôt que dans les seules probabilités du modèle. Les outils (MCP) exposent la pile DevOps ARCAD (DROPS, le référentiel de métadonnées, Builder) sous une forme standardisée : environ 80 points d’entrée DROPS sont ainsi accessibles à tout client MCP, qu’il s’agisse de l’agent ARCAD, de Copilot ou de Claude. L’action (le moteur de workflow) exécute les processus standards d’ARCAD de façon reproductible et auditable, les étapes sensibles restant soumises à validation humaine, exactement comme aujourd’hui.
Ce choix a un corollaire assumé : l’IA n’est pas le moteur, elle est l’assistant. Les résultats restent déterministes, pas une estimation probabiliste. La donnée de référence reste le référentiel ARCAD plutôt qu’une réponse du modèle, et il n’existe pas de boucle de correction incontrôlée où l’IA tenterait indéfiniment de se corriger elle-même. Chaque organisation choisit les étapes où l’IA intervient ; le produit continue de fonctionner sans elle, et le coût en jetons comme en risque reste prévisible.
Ce que ça donne en pratique
Ce type de discipline se vérifie à l’échelle. Chez Leumit Health Services, ARCAD Transformer Field a automatisé un projet d’expansion de champ sur l’ensemble du parc applicatif IBM i, dans le cadre d’un processus DevOps de bout en bout.
14 000
sources analysées
2 500
sources modifiées automatiquement
1 nuit
bascule, zéro retour arrière
« Ce projet d’expansion de code était d’une criticité absolue pour Leumit. Nous ne pouvions pas nous permettre de nous tromper. »
Aviv Rosenwasser, responsable du développement IBM i, Leumit Health Services
Par où commencer, un plan à 90 jours
L’adoption qui fonctionne suit un principe simple : démarrer petit, gouverner tout de suite, étendre ce qui marche.
Semaines 1–4
Un ou deux pilotes strictement en lecture, choisis pour les pierres d’achoppement qu’ils suppriment tout de suite : analyse d’impact, documentation, constitution de preuves.
Semaines 4–8
Les garde-fous se posent en parallèle : identités, portes de contrôle, archivage des preuves, Whitelist d’outils avec journalisation détaillée.
Semaines 8–12
Constitution d’équipes mixtes, profils IBM i et non-IBM i, pour élargir le périmètre sans concentrer le risque sur une poignée d’experts.
En continu
Des retours d’expérience sans recherche de faute et des playbooks partagés, pour que chaque incident évité profite à l’équipe suivante.
L’objectif n’est pas de mettre de l’IA partout. C’est de changer plus vite, sans jamais changer à l’aveugle.
ARCAD Software – Contenu basé sur les retours d’expérience et sessions techniques de l’ARCAD Summit.
À propos de l’auteur
Michel Mouchon
CTO et Business Line Manager DevOps
CTO d’ARCAD Software depuis 2000 et aujourd’hui Business Line Manager de la marque DevOps for Legacy, Michel Mouchon est chargé de définir la stratégie technologique globale d’ARCAD, pionnier du marché dans des domaines tels que le DevSecOps et la digitalisation, afin de stimuler la croissance de l’entreprise. À ce titre, il joue un rôle majeur dans la coordination des départements R&D, Ingénierie et Avant-vente. Michel s’est construit des compétences très transversales en informatique, en commençant sa carrière par un double diplôme en électronique et en génie logiciel. Sa curiosité pour les nouvelles technologies et pour leur mise en œuvre dans l’univers ARCAD et DevOps, ainsi que son talent pour la communication, ont renforcé la communauté des utilisateurs d’ARCAD et ont été déterminants dans la mise en lumière de nouvelles technologies, notamment aujourd’hui pour transcender l’accès aux produits et à la connaissance des applications grâce à l’IA, tout en tirant parti de la forte valeur ajoutée des solutions ARCAD.
DEMANDEZ VOTRE DÉMO
Parlons de votre projet !
Nos experts vous conseillent